
Wissen · Suchmaschinenoptimierung
KI-Crawler steuern: Wer darf Ihre Website lesen?
KI-Anbieter lesen Websites, um Modelle zu trainieren oder Antworten zu liefern. Über die robots.txt entscheiden Sie mit, wer das darf. Was jeder Bot tut und was eine Sperre bewirkt.
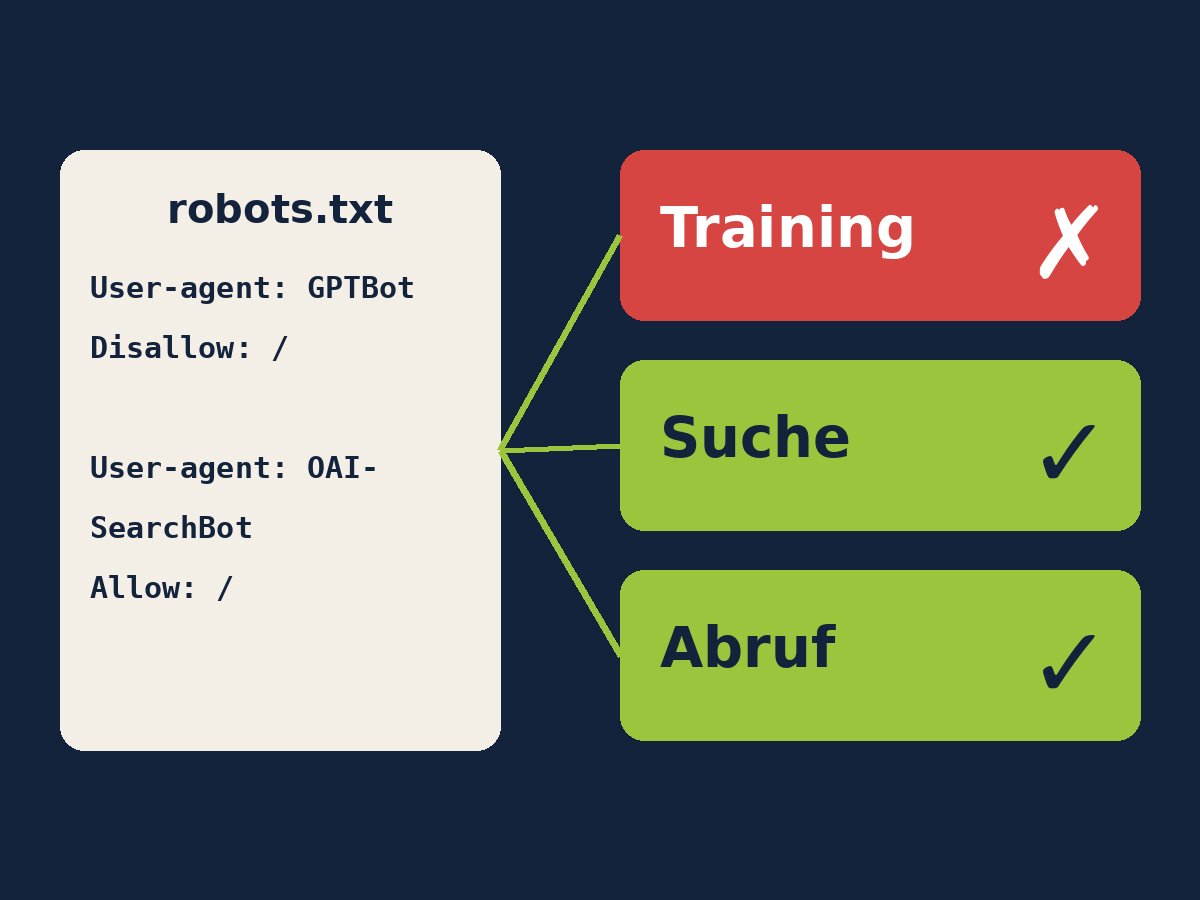
Wer eine Frage an ChatGPT, Claude oder Gemini stellt, bekommt Antworten, die auf gelesenen Webseiten beruhen. Ihre Website kann dazugehören. Ob und wofür, steuern Sie über eine kleine Textdatei, die robots.txt. Wichtig ist, die Bots zu unterscheiden: Nicht jeder liest zum selben Zweck.
- Die grossen Anbieter trennen Training, Suche und Abrufe auf Nutzeranfrage. Sie können jeden Bot einzeln steuern.
- Sie können das Training sperren und die Suche erlauben. So bleiben Sie in KI-Antworten auffindbar.
- Google-Extended betrifft Gemini, nicht die Google-Suche.
- Die robots.txt ist eine Bitte, keine technische Sperre. Nicht alle Crawler halten sich daran.
Wer liest wofür?
| Anbieter | Bot | Zweck | Wirkung einer Sperre |
|---|---|---|---|
| OpenAI | GPTBot | Training von Modellen | Inhalte sollen nicht fürs Training genutzt werden |
| OpenAI | OAI-SearchBot | Suche in ChatGPT | Seite erscheint nicht in den Suchantworten, höchstens als Link |
| OpenAI | ChatGPT-User | Aktionen von Nutzern in ChatGPT | Laut OpenAI gilt die robots.txt dafür möglicherweise nicht |
| Anthropic | ClaudeBot | Training von Modellen | Künftige Inhalte werden nicht fürs Training gesammelt |
| Anthropic | Claude-SearchBot | Indexierung für die Suche | Weniger Sichtbarkeit und Genauigkeit in Suchen von Nutzern |
| Anthropic | Claude-User | Abruf, wenn ein Nutzer fragt | Weniger Sichtbarkeit bei nutzergesteuerter Suche |
| Google-Extended | Training und Grounding von Gemini | Kein Einfluss auf Aufnahme oder Ranking in der Google-Suche |
So sieht eine Sperre aus
Die Datei liegt im Hauptverzeichnis Ihrer Domain (zum Beispiel ihredomain.ch/robots.txt), bei Subdomains je Subdomain. Ein Beispiel, das das Training sperrt, die Suche aber erlaubt:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /
Die Bot-Namen und ihre Aufgaben ändern sich. Prüfen Sie vor dem Einsatz die aktuellen Seiten der Anbieter, die wir unten verlinkt haben.
Schutz oder Sichtbarkeit: So entscheiden Sie
Was Sie wissen sollten
- IP-Sperren statt robots.txt: Anthropic weist darauf hin, dass das den Bot daran hindert, die robots.txt zu lesen, und deshalb keinen verlässlichen Ausschluss garantiert.
- Cloudflare blockiert seit dem 1. Juli 2025 KI-Crawler standardmässig, ausser sie zahlen. Wer Cloudflare nutzt, sollte die Einstellungen prüfen, damit die eigene Wahl dort ankommt.
- Nicht jeder hält sich an die Regeln: Cloudflare hat im August 2025 Perplexity vorgeworfen, Sperren mit getarnten Crawlern zu umgehen. Eine Stellungnahme von Perplexity haben wir nicht gelesen.
Für die meisten KMU ist ein Mittelweg sinnvoll: Training bewusst entscheiden, Suche erlauben, Wertvolles hinter einen Login stellen. Ob und wie Sie rechtlich gegen das Auslesen vorgehen können, ist eine Rechtsfrage. Dieser Beitrag gibt keine Rechtsauskunft.
Stand: 30.10.2026. Quellen: OpenAI: Overview of OpenAI Crawlers; Anthropic: Crawler und robots.txt (Stand 7.4.2026); Google: Common crawlers (Stand 15.10.2026); Cloudflare, 1.7.2025; Cloudflare zu Perplexity, 4.8.2025.
Weiterlesen
 WissenKI-Suche und SEO: Was Sie für AI Overviews wirklich tun müssen
 WissenLinkedIn und KI-Suche: Was wird zitiert?
Passende Leistungen
Fragen zu diesem Thema?
Wir beraten Sie gerne: persönlich, verständlich und unverbindlich.